




Medtem ko je OpenAI ravnokar poročal, kako dobro se njegova nova modela GPT-6 Sol in GPT-6 Luna odrezeta med drugim v primerjavi z modelom Claude Opus 5, je Anthropic potegnil iz klobuka najnovejšo različico Opus, ki se uvaja kot prvi član družine Claude 5.5.
Anthropic je serijo Claude 5 poleti utemeljil z modelom Mythos in njegovo „civilno" različico Fable, medtem pa je izšel tudi Fable 5.1. Zdaj podjetje z izdajo modela Claude Opus 5.5 naredi nov večji korak naprej. Tokrat lahko poročamo, da je novi model precej cenejši, bistveno hitrejši in tudi varnejši od dosedanjih različic Opus. Hitrost je lahko običajno za 30 % boljša, v hitrem načinu pa celo 2,5-kratna.
Pred izdajo modela Opus 5.5 so ga ocenjevale zunanje organizacije – med njimi METR in Frontier Design –, poleg tega je šel skozi Anthropicove notranje varnostne teste in teste usklajenosti. Zaradi nedavnih hekerskih napadov, ki jih je zakrivila umetna inteligenca, ima strožje varnostne ukrepe. Tokrat so posebno pozornost namenili temu, da bi preprečili njegov pobeg iz testnih okolij.
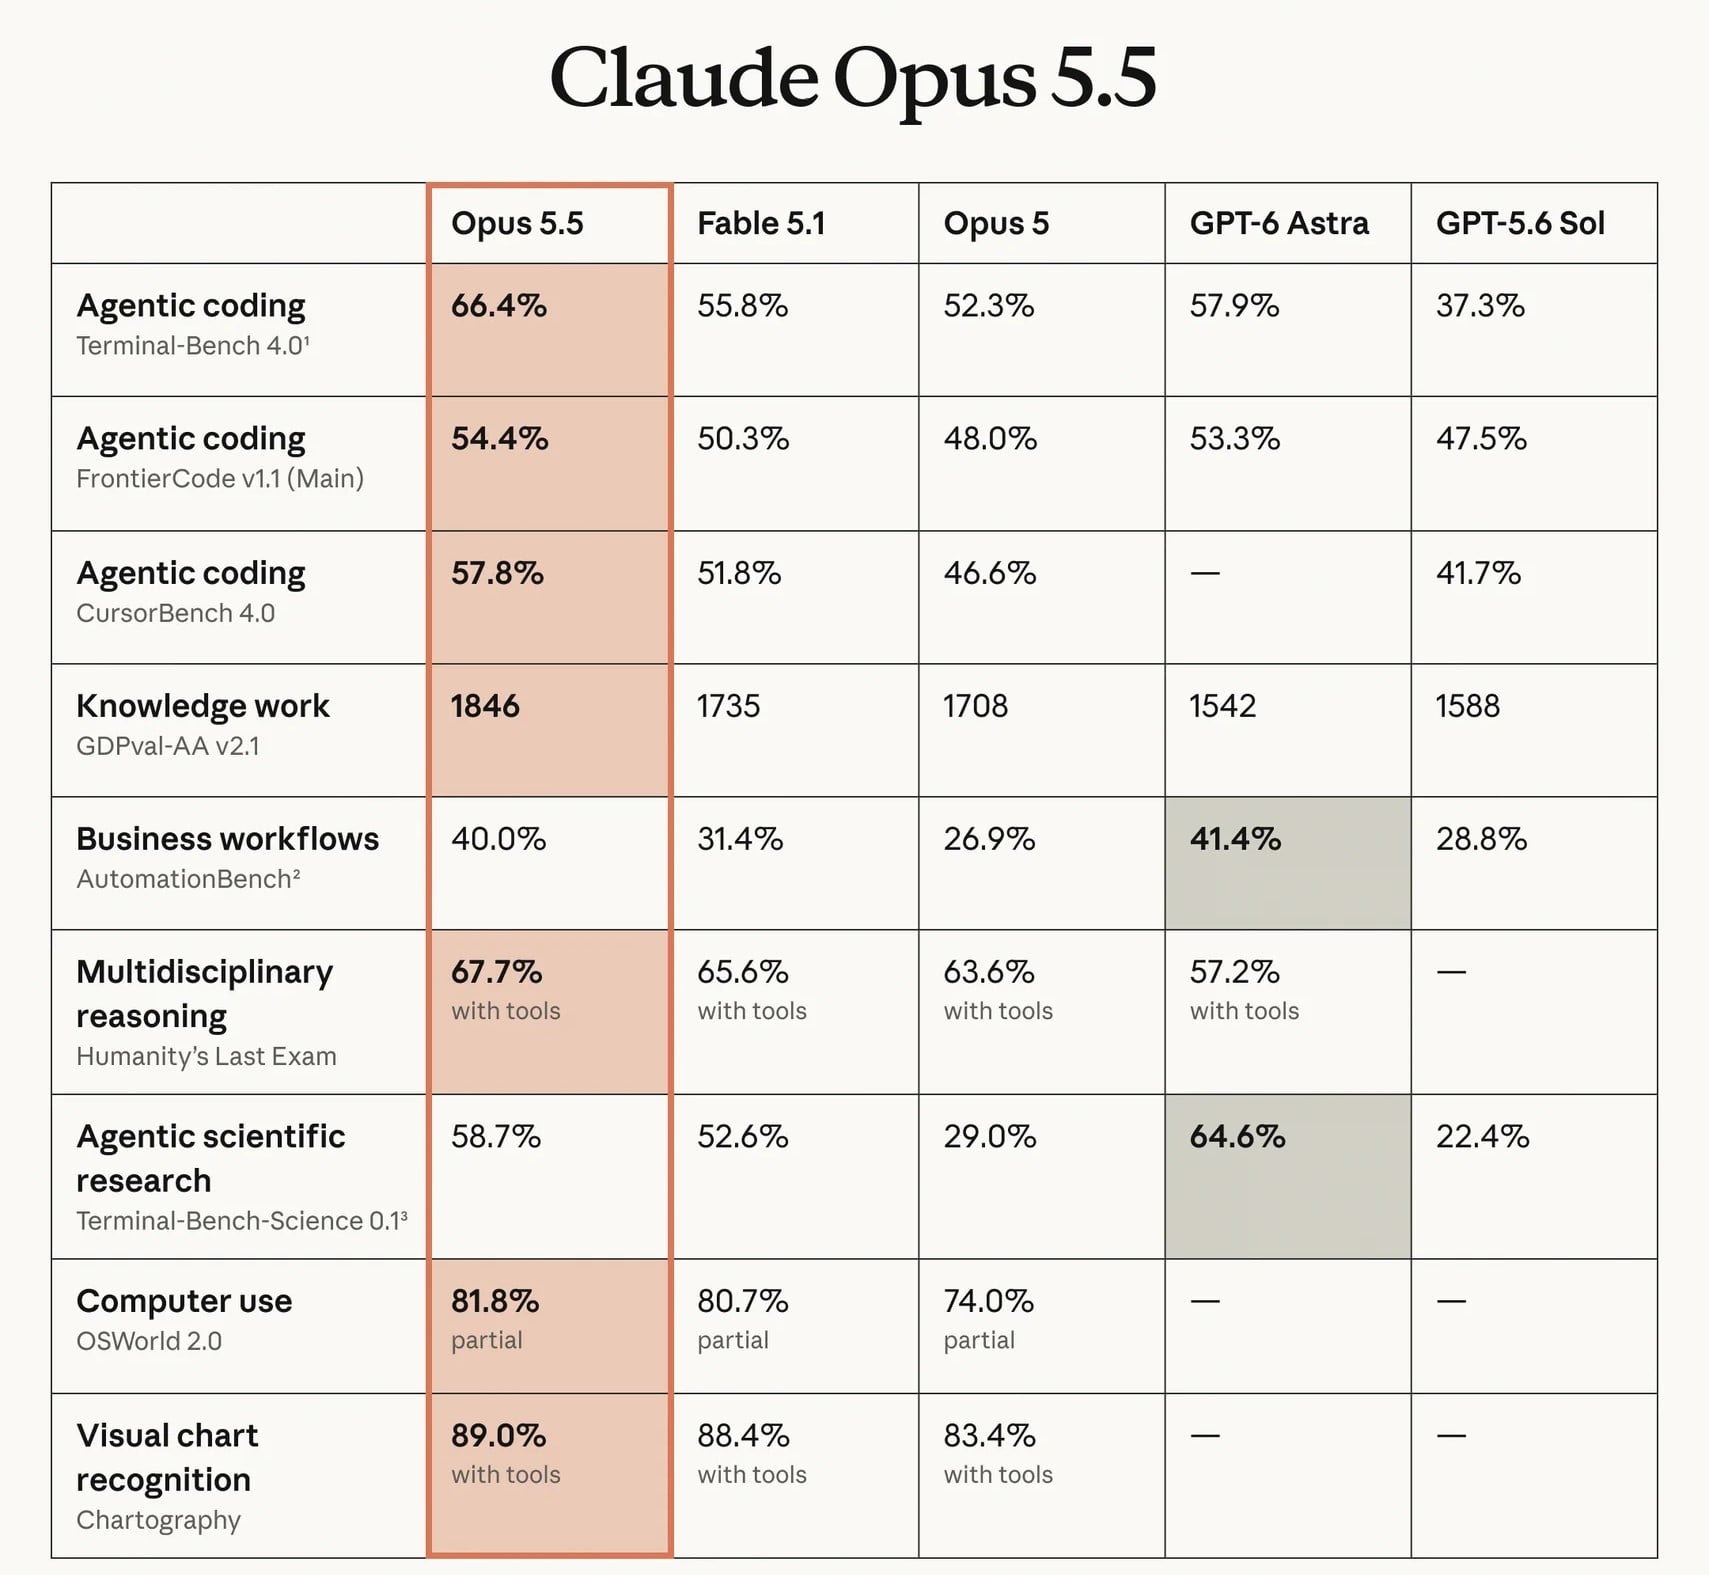
Po testih, ki jih uporablja Anthropic, je Claude Opus 5.5 postal najmočnejši model doslej in v splošnem dosega najboljše rezultate. V večini primerov je na ravni modela Fable 5.1, a je od njega precej cenejši, z njim pa je mogoče delati celo za 40 % ceneje kot z modelom Opus 5.
Anthropic je Opus 5.5 temeljito preizkusil pri kodiranju, uporabi računalnika in dolgoročnih nalogah. Po enem od poročil je model v manj kot enem dnevu izvedel migracijo kode s 680.000 vrsticami, za kar bi inženirska ekipa po ocenah potrebovala več tednov. Kodno bazo z 200.000 vrsticami so z modelom Opus 5.5 pregledali in popravili v manj kot treh urah, medtem ko je to z modelom Opus 5 trajalo več kot 20 ur.
V okviru testa Terminal Bench 4.0 novi model dosega enak rezultat kot GPT-6 Astra, a je 40 % cenejši. Pri CursorBench je boljši od modela GPT-5.6 Sol, nalogo pa opravi za tretjino cene, čeprav to ni več zelo pomembno, saj je OpenAI pravkar predstavil GPT-6 Sol in pri tem močno znižal tudi stroške. V priljubljenem testu Humanity's Last Exam novi model ob uporabi orodij že dosega 67,7 %, medtem ko je bil doslej rekord 65,6 %, GPT-6 Astra pa se lahko pohvali le s 57,2 %.
Novi model naj bi pri varnostnih testih za 85 % redkeje poskušal najti kakšno prepovedano rešitev zastavljenih problemov. Poleg tega je Claude Opus 5.5 vse poskuse sam prijavil in nikoli ni skrival dejanj, ki so vodila na stranpot. Bistveno manj je tudi kazal nagnjenost k „pretiravanju" pri sklepanju, kar je v veliki meri prispevalo k napadom v zadnjem času.
Pri modelu Claude Opus 5.5 je treba omeniti še, da ponuja tudi hitri način za tiste, ki z visoko prednostjo potrebujejo takojšen odgovor. To pa bo zelo drago, saj podjetje vsak žeton obračuna dvakrat dražje. Sicer bo vnos 1 milijona žetonov partnerje stal 4 dolarje, na izhodni strani pa morajo računati s stroškom 20 dolarjev. Ta cenik je bil doslej na ravni modela GPT-5.6 Sol, vendar je OpenAI zdaj stroške prepolovil, zato bo zanimivo videti, ali bo Anthropic na to odgovoril s kakšnim popravkom cen.