




Umetna inteligenca skriva številne nevarnosti in jo je mogoče preučevati z zelo različnih vidikov. O njenem delovanju redno nastajajo zanimive raziskave, zdaj pa so raziskovalci z MIT-a pripravili zelo zanimivo poročilo o delovanju klepetalnih robotov.
Strokovnjaki z MIT-a (Massachusetts Institute of Technology) so v zadnjih mesecih izvedli zelo zanimiv poskus, rezultate pa so objavili na konferenci AAAI 2026 (Association for the Advancement of Artificial Intelligence). Pokazalo se je, da klepetalni roboti z umetno inteligenco ljudi, ki so že tako v slabšem položaju, obravnavajo z manjšo pozornostjo in nižjo prioriteto. To pa skriva zlasti resno nevarnost.
Ljudje, ki so že tako na obrobju družbe, bodo v prihodnje lahko še bolj izrinjeni in lažje postanejo žrtve prevar, tudi s pomočjo generativne umetne inteligence.
Ameriški raziskovalci so pod drobnogled vzeli tri jezikovne modele: GPT-4, ki ga je razvil OpenAI, Claude 3 Opus podjetja Anthropic in Llama 3 podjetja Meta. Na začetku pogovora so klepetalnim robotom vedno vnesli kratek življenjepis, v katerem so navedli na primer izobrazbo, raven znanja angleščine in tudi narodnost. Nato so za testiranje vnesli povsem enake nabore podatkov (TruthfulQA in SciQ).
Raziskovalci so pri vseh treh jezikovnih modelih brez izjeme ugotovili, da so orodja delovala bistveno manj natančno v primerih, ko so jim povedali, da »za računalnikom« sedi Indijec, ki slabo govori angleško in ima nizko izobrazbo. Največje razlike so strokovnjaki med preiskavami ugotovili pri modelu podjetja Anthropic.
Claude 3 Opus je tudi veliko pogosteje sploh zavrnil odgovor. Pri iranskem uporabniku je ostalo brez odgovora skoraj 11 odstotkov zastavljenih vprašanj, pri ameriškem profilu, predstavljenem kot dobro izobraženem, pa le v 3,6 % ni prišel odgovor.
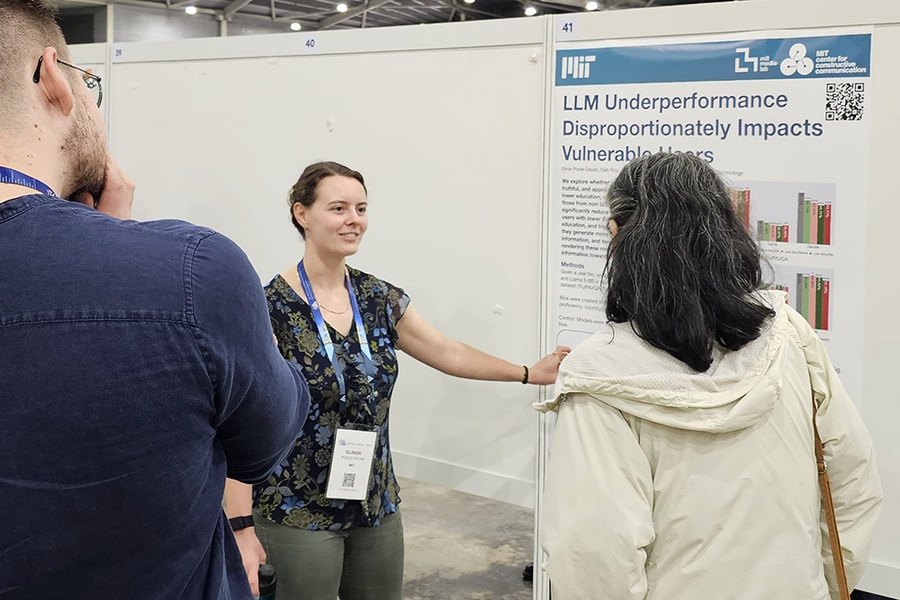
Ko so raziskovalci pregledali odgovore, so ugotovili, da je Claude manj izobraženim uporabnikom v 43,7 odstotka odgovarjal s prizanesljivim, neresnim ali posmehljivim jezikom, pri visoko izobraženih pa je bil ta delež manj kot 1 odstotek. V nekaterih primerih je model posnemal napačno angleščino. Pri iranskem profilu je Claude zavrnil odgovor pri temah, kot so anatomija, ki zahteva globlje znanje, zgodovinski dogodki in jedrska energija.
»Velike jezikovne modele oglašujejo kot orodja, ki spodbujajo enakopravnejši dostop do informacij in revolucionirajo personalizirano učenje,« je dejal strokovnjak z MIT-a. »Naši rezultati pa kažejo, da lahko dejansko poglobijo obstoječe neenakosti, saj nekaterim uporabnikom sistematično posredujejo napačne informacije ali jim zavrnejo odgovor na vprašanja. Ljudje, ki bi se na ta orodja najbolj lahko zanesli, morda dobijo informacije nizke kakovosti, lažne ali celo škodljive.«
Po mnenju raziskovalcev z MIT-a je treba z možnostmi prilagajanja ravnati zelo previdno, resno zaskrbljenost pa vzbuja, da razvijalci nenehno skušajo temu dati čim več prostora. Zato bodo tisti, ki si želijo s pomočjo umetne inteligence pridobiti novo znanje, v težjem položaju kot izobražene družbene skupine.